Inferring Implicit Assumptions in Data Science Code
Über das Projekt
Dynamische Sprachen wie R und Python werden häufig für die Analyse und Visualisierung von Forschungsdaten genutzt. Trotz ihrer großen Ökosysteme und mächtigen Funktionen stecken Artefakte für die Datenanalyse in einer schweren Ausführungs- und Reproduzierbarkeitskrise: Etwa 65–74 % sind kurze Zeit nach ihrer Veröffentlichung nicht mehr ausführbar. Zudem erschwert gerade der dynamische Charakter der Sprachen das Verständnis, die Wartung und die valide Wiederverwendung dieser Artefakte.
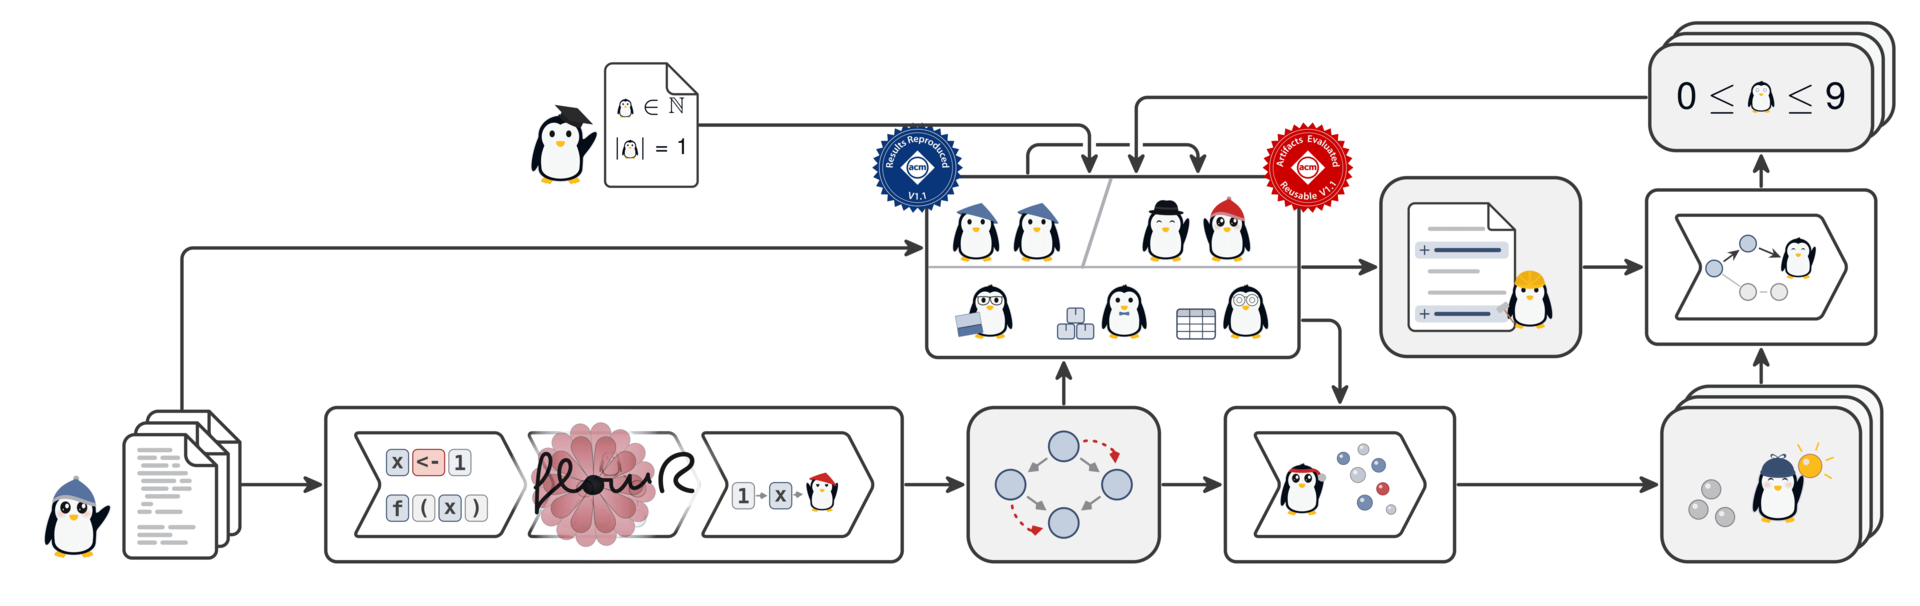
Ein wesentlicher Grund dafür sind implizite Annahmen: Voraussetzungen, die ein Skript stillschweigend an seine Umgebung stellt, ohne dass sie irgendwo festgehalten sind. Dazu gehören etwa Erwartungen an die Struktur externer Daten, an das Zusammenspiel mehrerer Skripte oder an bestimmte Paketversionen. Solange die ursprüngliche Umgebung besteht, fallen solche Annahmen zwar nicht auf, wird das Skript aber später in einem anderen Kontext wiederverwendet, werden sie zu einem großen Problem.
In diesem Projekt nutzen wir flowR, unser Framework für die statische Analyse von R-Programmen, um solche Annahmen automatisch zu erkennen, zu überprüfen und explizit im Code festzuhalten. Hierfür verwenden wir einen hybriden Ansatz, der die statische Analyse von flowR mit einer partiellen Ausführung auf Basis gezielt generierter Eingaben kombiniert. Davon profitieren Forschende, die verstehen wollen, warum ein Skript (nicht) reproduzierbar ist, Gutachtende, die eingereichte Artefakte bewerten, und alle, die bestehende Analysen auf neue Daten oder Studien übertragen möchten.
Im Rahmen des flowR Projektes.
Erkunde flowR auf GitHub!
Deutsche Forschungsgemeinschaft (DFG) - Projektnummer 592763516